Assistente IA ibrido – L’evoluzione degli agenti di oggi
Ho scritto personalmente questo articolo e poi ho chiesto all’IA di migliorare il mio inglese.
Questa è la mia opinione personale, da architetto di soluzioni che da 20 anni sviluppa software cloud e piattaforme dati. È più che altro una riflessione su come immagino Actor tra 1-2 anni.
Man mano che gli assistenti IA diventano più capaci, l’architettura sottostante diventa importante quanto i modelli stessi. Attualmente, la valutazione degli agenti si basa sui modelli utilizzati, sul framework e sui prompt.
Per sistemi come Actor, progettati per operare tra email, calendari, documenti e flussi di lavoro aziendali, un approccio interamente basato sul cloud o interamente locale raggiunge rapidamente i propri limiti.
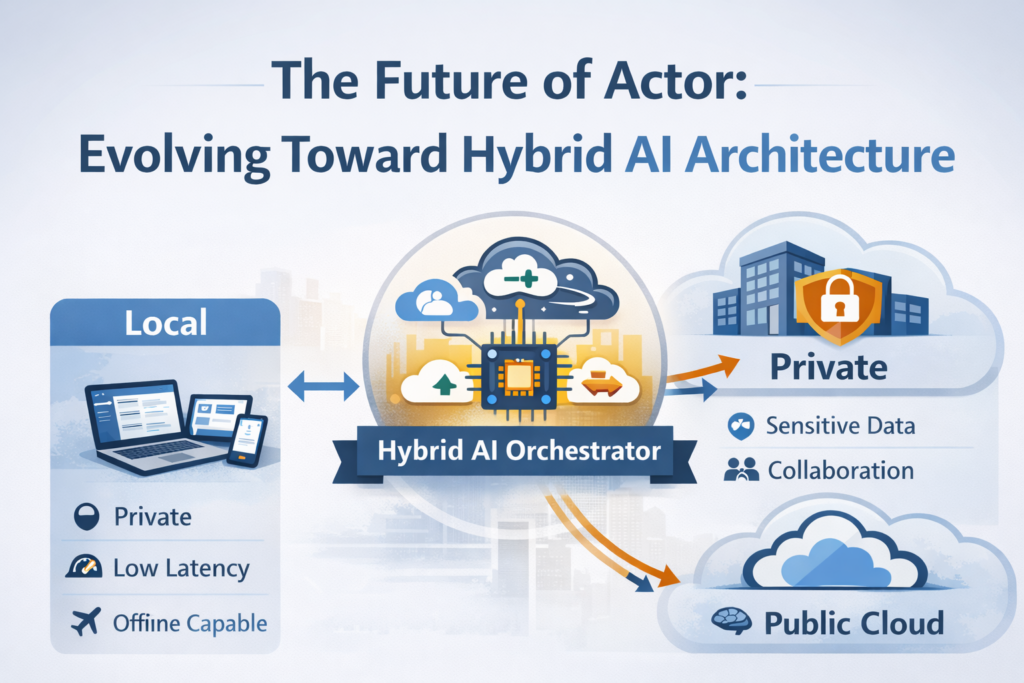
Ciò che inizia invece a delinearsi è una architettura ibrida, in cui l’intelligenza e l’esecuzione sono distribuite tra dispositivi locali, infrastrutture private e modelli cloud.
Non si tratta tanto di una preferenza tecnologica, quanto di una necessità architetturale.
I limiti di un assistente interamente basato sul cloud
La maggior parte degli assistenti IA attuali opera principalmente nel cloud. All’inizio è una scelta sensata: i modelli sono grandi, l’infrastruttura è centralizzata e gli aggiornamenti sono semplici. Inoltre, l’inferenza è economica (almeno per alcuni modelli).
Ma quando un assistente si integra profondamente nei sistemi di lavoro, emergono alcuni problemi strutturali.
Innanzitutto, i confini dei dati contano.
Gli assistenti di lavoro interagiscono con informazioni altamente sensibili: documenti finanziari, email interne, contratti, piani di sviluppo dei prodotti e discussioni sulle risorse umane. Molte organizzazioni non possono, per legge o per ragioni operative, trasmettere continuamente questi dati a infrastrutture esterne.
Poi la connettività diventa una dipendenza.
Un assistente di lavoro che smette di funzionare in aereo, in una galleria ferroviaria o in caso di problemi di rete diventa inaffidabile nelle attività quotidiane.
L'IA cloud è potente, ma non può realisticamente gestire ogni livello del sistema.
I limiti di un assistente interamente locale
All'estremo opposto, anche eseguire tutto localmente comporta vincoli importanti.
I modelli di ragionamento più capaci richiedono ancora risorse computazionali considerevoli. Sebbene l'hardware locale stia migliorando rapidamente — Apple Silicon, NPU e chip IA dedicati — eseguire modelli all'avanguardia per ragionamenti complessi o la sintesi di più documenti resta poco pratico sulla maggior parte dei dispositivi.
In secondo luogo, la latenza si accumula nei flussi di lavoro degli agenti.
Un assistente che svolge più passaggi, come leggere un'email, estrarre le attività, controllare il calendario, preparare una risposta e programmare promemoria, crea una catena di chiamate ai modelli e interazioni con le API. Anche piccoli ritardi si sommano quando le azioni vengono eseguite in sequenza.
C'è anche una sfida di governance.
Gestire i modelli su migliaia di dispositivi dei dipendenti comporta una complessità operativa: aggiornamenti, patch di sicurezza, gestione della configurazione e monitoraggio della conformità.
Infine, molti flussi di lavoro dell'assistente richiedono stato condiviso.
Una timeline di progetto, una base di conoscenze del team o un sistema collaborativo di gestione delle attività non possono risiedere interamente sul computer di una sola persona.
La sola intelligenza locale non può nemmeno offrire un quadro completo.
Una direzione probabile: intelligenza distribuita
Un'architettura più naturale per assistenti come Actor è un modello di intelligenza distribuita, in cui i diversi livelli del sistema vengono eseguiti in ambienti diversi.
Una suddivisione semplificata potrebbe essere questa:
Livello locale (ambiente di esecuzione del dispositivo)
Responsabile della conoscenza dell'ambiente dell'utente e dell'esecuzione rapida delle azioni.
Responsabilità tipiche:
- accedere a file, app e notifiche locali
- rilevare segnali contestuali (documenti aperti, riunioni, email)
- eseguire azioni rapide e private
- memorizzare nella cache le conoscenze usate di frequente
Infrastruttura privata (cloud dell'organizzazione o dell'utente)
Responsabile dello stato condiviso e del trattamento dei dati sensibili.
Responsabilità tipiche:
- basi di conoscenza aziendali
- memoria condivisa dell'agente
- contesto di collaborazione del team
- elaborazione di documenti sensibili
Modelli di cloud pubblico
Responsabile del ragionamento complesso e della gestione di grandi quantità di conoscenze.
Responsabilità tipiche:
- attività di ragionamento approfondito
- sintesi complesse di numerosi documenti
- recupero di grandi quantità di conoscenze
- capacità linguistiche avanzate
In questo modello, il runtime locale funge da orchestratore, decidendo dove eseguire ogni attività.
L’importanza del confine di fiducia
Una delle decisioni progettuali più importanti consiste nel definire il confine di fiducia.
In termini pratici, ciò significa rispondere a domande come:
- Quali dati non lasciano mai il dispositivo?
- Quali dati possono essere trasferiti a un'infrastruttura privata?
- Quali attività possono utilizzare in sicurezza modelli esterni?
- Come vengono registrate e verificate queste decisioni?
Questo confine diventa fondamentale per l'adozione in ambito aziendale.
Le organizzazioni non vogliono solo funzionalità di IA: vogliono prevedibilità e controllo sul flusso dei dati.
Perché è probabile che questa architettura diventi uno standard
Diverse tendenze del settore indicano questa direzione.
L'accelerazione hardware sta migliorando rapidamente sui dispositivi locali, consentendo l'uso di modelli leggeri e inferenze locali rapide.
Al contempo, le capacità dei modelli all'avanguardia continuano a crescere negli ambienti cloud, mantenendo un divario che rende interessante il ragionamento nel cloud per le attività complesse.
Le aziende richiedono sempre più garanzie di governance dei dati, orientando i sistemi di IA verso architetture in grado di rispettare i confini interni.
Infine, i framework emergenti per gli agenti sono già basati su instradamento multi-modello, in cui modelli diversi e ambienti di esecuzione gestiscono attività diverse.
Le architetture ibride si adattano naturalmente a questo schema.
Cosa significa per Actor
Per Actor in particolare, un’architettura ibrida potrebbe sbloccare diverse funzionalità:
Un ambiente di esecuzione locale potrebbe comprendere continuamente l’ambiente dell’utente, il contesto delle email, le riunioni e i documenti, senza dover trasmettere tutto all’esterno.
Un livello di infrastruttura privata di Actor potrebbe gestire la memoria dell’utente, i grafi delle attività e il contesto collaborativo.
I modelli cloud potrebbero quindi essere attivati selettivamente per le attività che richiedono davvero un ragionamento più approfondito.
Invece di un singolo endpoint di IA, Actor diventa un sistema che coordina l’intelligenza su più livelli.
Questa architettura consente inoltre a utenti e organizzazioni di scegliere diverse strategie di implementazione in base alle proprie esigenze:
- cloud personale
- infrastruttura aziendale
- ibrido, locale + cloud
- implementazioni completamente private
In altre parole, Actor evolve da semplice assistente a livello cognitivo distribuito per il lavoro.
Uno sguardo al futuro
È probabile che il futuro degli assistenti per il lavoro non sarà definito da un singolo modello o fornitore.
Piuttosto, sarà determinato da come viene orchestrata l’intelligenza nei diversi ambienti.
I sistemi in grado di combinare privacy, reattività e capacità di ragionamento avanzate avranno un vantaggio strutturale.
Le architetture ibride sembrano essere una delle soluzioni più promettenti per raggiungere questo equilibrio.
P.S.: sto riprogettando l’intera architettura per prepararla a un modello ibrido nel prossimo futuro. È un lavoro impegnativo e ci vorrà del tempo, ma è la mia passione.